Recherchiert ein KI-Agent im Auftrag eines Einkäufers nach Lieferanten und kann Ihre Website nicht lesen, beschreibt er Ihr Unternehmen anhand der Quellen aus zweiter Hand, die er auftreiben kann, oder er übergeht Sie ganz. Das ist das geschäftliche Risiko, und es ist kein theoretisches. Laut dem „2025 Buyer Experience Report“ von 6sense nutzten 94 % der B2B-Käufer LLMs, um Bewertungen zusammenzufassen oder Daten zu analysieren, und 94 % der Einkaufsgremien hatten ihre bevorzugten Anbieter bereits in eine Rangfolge gebracht, bevor sie zum ersten Mal Kontakt zum Vertrieb aufnahmen. In 77 % der Fälle kauften die Käufer anschließend bei diesem vorläufigen Favoriten.
Wenn die Entscheidung Gestalt annimmt, bevor überhaupt jemand zum Telefon greift, lautet die Frage: Kann ein Agent Ihre Website finden, sie ohne JavaScript-Rendering auswerten und die Fakten herausziehen, auf die es ankommt (Leistungen, Standorte, Kontakte, der Weg zur Zusammenarbeit)? Wenn nicht, prägen Vermutungen das Bild Ihrer Marke. Genau das prüfen vier öffentliche Tools. Einen gemeinsamen Standard teilen sie nicht. Nutzen Sie alle vier, verstehen Sie, was jedes einzelne prüft, und beheben Sie nur echte Lücken.
Is It Agent Ready prüft die Discovery-Dokumente, nach denen ein Agent sucht, wenn er auf eine Domain kommt: robots.txt und die Sitemap, Link-Header, einen API-Katalog (RFC 9727), OAuth-Metadaten, eine MCP Server Card, eine A2A Agent Card, Agent Skills, WebMCP und einen ARD-Katalog, dazu Markdown Content Negotiation und Regeln für KI-Bots. Das Tool weist ein Level aus, höchstens Level 5.
Warum ist das wichtig? Das sind die Signale auf Protokollebene, die einem Agenten sagen, was Ihre Website anbietet und wie er programmatisch mit ihr interagieren kann. Fehlen sie, weicht der Agent auf HTML-Scraping aus, das fehleranfällig und lückenhaft ist. Ein Detail verdient Beachtung: Die Prüfung der DNS-basierten Agent Discovery setzt DNSSEC beim Domain-Registrar voraus. Das ist also Aufgabe derjenigen, die Ihr DNS verwalten, nicht allein des Webteams.
Erster Schritt: Starten Sie den Scan, prüfen Sie, ob robots.txt und Sitemap vorhanden und korrekt sind, und vergewissern Sie sich, dass DNSSEC bei Ihrem Registrar aktiviert ist.
Is Agentic stellt eine grundlegendere Frage: Können die User Agents von KI-Agenten die Website überhaupt erreichen? Das Tool prüft, ob Inhalte ohne JavaScript lesbar sind, ob es eine llms.txt gibt, ob eine auth.md vorhanden ist und ob die Seiten in das Kontextbudget eines Agenten passen (die Textmenge, die ein LLM in einem einzigen Durchgang verarbeiten kann).
Genau hier scheitern viele Unternehmenswebsites, ohne dass es jemand bemerkt. Eine JavaScript-lastige Single-Page-Application, die im Browser einwandfrei aussieht, liefert einem Agenten, der keinen clientseitigen Code ausführt, womöglich nichts Brauchbares. Das Kontextbudget ist ein weiterer blinder Fleck: Eine Seite voller Navigationselemente, Cookie-Banner und Textbausteine kann mehr umfassen, als ein Agent aufnehmen kann, sodass der eigentliche Inhalt abgeschnitten oder verworfen wird.
Erster Schritt: Prüfen Sie, ob Ihre wichtigsten Seiten bei deaktiviertem JavaScript aussagekräftige Inhalte liefern, und gleichen Sie den Umfang der Seiten mit der Prüfung des Kontextbudgets ab.
Mintlify Score baut auf den Open-Source-Prüfungen von AFDocs auf. Bewertet werden Qualität und Abdeckung der llms.txt, die Verfügbarkeit von Markdown-Versionen der Seiten unter .md-URLs, Directives, die Agenten auf die llms.txt verweisen, die Seitengröße und die Übereinstimmung zwischen HTML- und Markdown-Version einer Seite.
Die Übereinstimmung ist wichtig: Erhält ein Agent eine Markdown-Version, der die Hälfte des Inhalts des HTML-Originals fehlt, fasst er Ihr Unternehmen unvollständig oder irreführend zusammen. Cloudflare zufolge besteht die Markdown Content Negotiation die Prüfung nur bei 3,9 % der Websites in seinem gescannten Datensatz. Die Messlatte liegt also niedrig, und wer hier handelt, setzt sich messbar ab.
Eine Einschränkung: SE Ranking hat rund 300.000 Domains untersucht und keinen messbaren Zusammenhang zwischen einer vorhandenen llms.txt und der Häufigkeit gefunden, mit der eine Domain in KI-Antworten zitiert wird. Betrachten Sie llms.txt daher als Hygienefaktor für die Auffindbarkeit, nicht als Garantie für Zitierungen.
Erster Schritt: Prüfen Sie, ob Ihre Website eine llms.txt und .md-URLs hat, und vergleichen Sie bei Ihren wichtigsten Seiten die Markdown-Ausgabe mit dem HTML.
Ora führt 132 Prüfungen in neun Zielen durch, darunter Discovery, Vertrauen, Integration, Authentifizierung und Zahlungen. Was Ora unterscheidet, ist der Umfang: Viele Prüfungen betreffen Einträge außerhalb der Website, etwa in MCP-Registries und Knowledge Graphs. Ein Teil des Scores hängt also an geschäftlichen Aufgaben und an Einträgen in Verzeichnissen, nicht an Änderungen der Website. Außerdem bietet Ora mit Journey ein eigenes Produkt an, das einen echten Agenten mit einer Absicht Ihrer Wahl auf eine Domain ansetzt und jeden Schritt aufzeichnet.
Diese Unterscheidung ist wichtig, denn eine reine Checkliste lässt sich austricksen. Eine Website kann eine MCP Server Card deklarieren, die ins Leere zeigt, und ein statischer Scanner lässt sie durchgehen. Ein Agent, der den Ablauf tatsächlich durchspielt, deckt den Fehler auf. Und das führt zum wichtigsten Punkt dieses ganzen Artikels.
Erster Schritt: Führen Sie den Ora-Scan durch und teilen Sie die Ergebnisse auf in Korrekturen an der Website (Webteam) und Aufgaben rund um Einträge und Registries (Geschäfts- oder Marketingteam).
| Tool | Was es prüft | Was es nicht prüft | Wer die Ergebnisse umsetzt |
|---|---|---|---|
| Is It Agent Ready | Discovery-Dokumente, Protokollsignale, DNS-basierte Discovery, Markdown Negotiation, Regeln für KI-Bots | Einträge außerhalb der Website, Inhaltsqualität, Verhalten von Agenten | Webteam, DNS-Administration |
| Is Agentic | Erreichbarkeit für Agenten, Lesbarkeit ohne JavaScript, llms.txt, auth.md, Kontextbudget | API-Kataloge, Discovery auf Protokollebene, Signale außerhalb der Website | Webteam |
| Mintlify Score | Qualität der llms.txt, .md-URLs, Directives, Seitengröße, Übereinstimmung von HTML und Markdown | Discovery auf Protokollebene, Authentifizierung, Einträge außerhalb der Website | Webteam, Content-Team |
| Ora | 132 Prüfungen in neun Zielen, einschließlich Einträgen und Registries außerhalb der Website | Tiefergehende Discovery-Signale auf Protokollebene (abgedeckt von Is It Agent Ready) | Webteam und Geschäft/Marketing |
Für das Geschäft: Das Unternehmen wird gefunden und korrekt beschrieben, wenn ein Agent die Recherche übernimmt. Die Fakten, auf die es ankommt (Leistungen, Standorte, Kontakte, der Weg zur Zusammenarbeit), stammen von Ihrer eigenen Website statt aus Vermutungen. Partner und ihre Agenten können Ihre dokumentierten Schnittstellen nutzen, ohne dass vorher ein Termin nötig ist. Und Sie erhalten eine messbare Ausgangsbasis statt einer Meinung.
Für die Marke: Kontrolle darüber, wie KI-Assistenten Sie beschreiben. Einheitliche Fakten in jedem Kanal, den ein Agent liest. Glaubwürdigkeit bei technisch versierten Käufern, die diese Signale prüfen. Und Ehrlichkeit, denn ein Agent, der in einen defekten Ablauf geschickt wird, behält die Marke als unzuverlässig in Erinnerung.
Diese Scores messen die technischen Voraussetzungen dafür, dass KI ein Unternehmen findet und versteht. Sie messen nicht, ob KI-Assistenten das Unternehmen tatsächlich zitieren. Eine Studie von The B2B Answer zu deutschsprachigen Suchanfragen aus der Industrie ergab, dass KI-Antworten auf Normungsorganisationen, Verbände und Unternehmenswebsites zurückgreifen. Ob Ihre Website zu diesen Quellen gehört, hängt von mehr ab als von einem bestandenen Readiness-Scan. Messen Sie Zitierungen gesondert: mit einem festen Satz von Käuferfragen, die Sie KI-Assistenten über einen längeren Zeitraum immer wieder stellen.
Deklarieren Sie nur, was Sie tatsächlich betreiben. Die Scanner lesen meist nur die Deklarationen, ohne den Dienst aufzurufen. Eine vorgetäuschte Deklaration kann also einen Score anheben, schickt aber echte Agenten in scheiternde Abläufe und beschädigt das Vertrauen. Wenn Sie eine MCP Server Card deklarieren, stellen Sie sicher, dass der Server antwortet. Wenn Sie eine llms.txt veröffentlichen, sorgen Sie dafür, dass die Inhalte dahinter auf dem neuesten Stand sind.
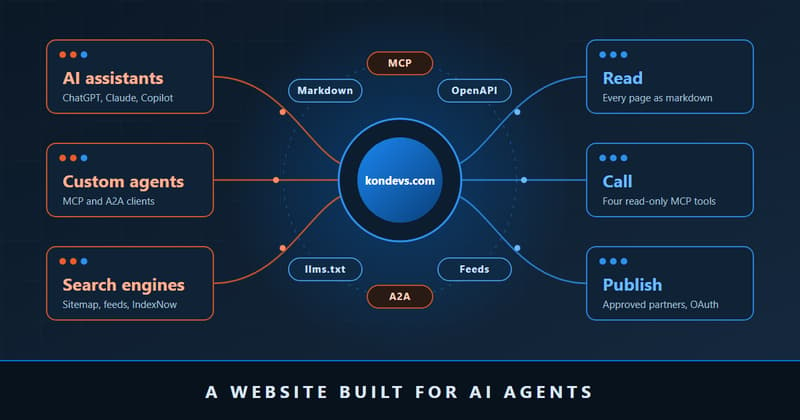
Am 17. Oktober 2026 stieg kondevs.com im Mintlify Score von 82 auf 98 und bei Ora von 90 auf 93, erreichte 100/100 bei Is Agentic und 93 (Level 5) bei Is It Agent Ready. Alle Einzelheiten stehen in der Fallstudie von KONDEVS zur Agent-Readiness.
Der erste Schritt: Lassen Sie alle vier Scanner über Ihre Domain laufen. Lesen Sie nach, wie jede Prüfung funktioniert. Beheben Sie echte Lücken, ignorieren Sie Kosmetisches und deklarieren Sie nie eine Fähigkeit, die Sie nicht tatsächlich bereitstellen. Die Scores sind eine Diagnose, kein Ziel. Entscheidend ist, ob ein Agent, der auf Ihre Website kommt, sie mit den richtigen Fakten wieder verlässt.