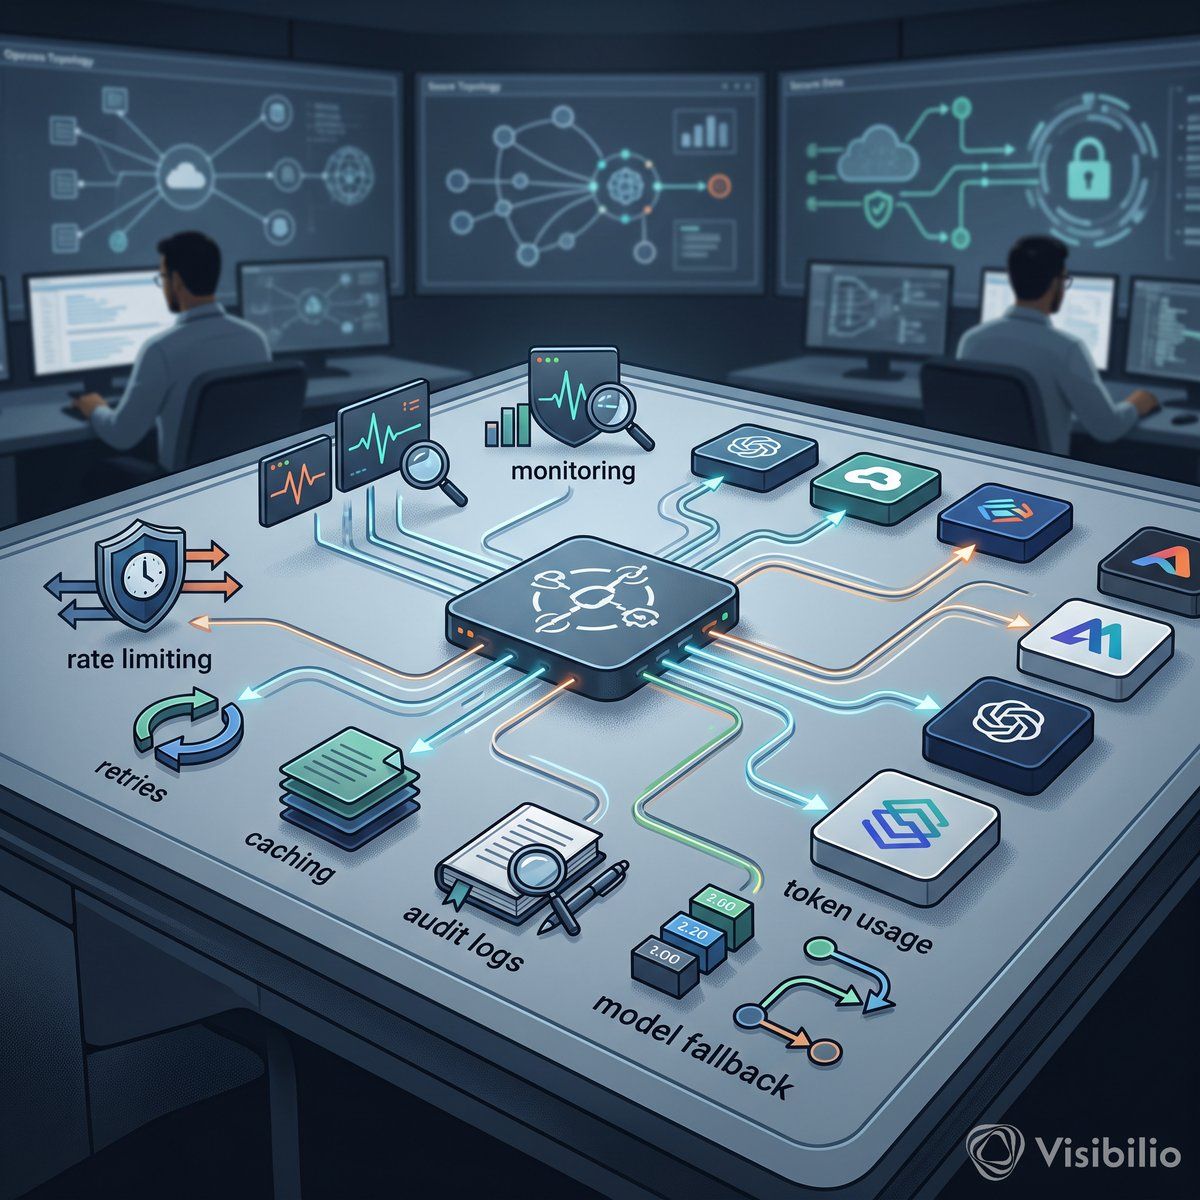
Cloudflare AI Gateway ist ein Proxy zwischen Ihren Anwendungen und den KI-Anbietern, der Logging, Caching, Rate Limits und Ausgabenlimits, Retries und Modell-Fallback an einer Stelle bündelt. Bewusst eingesetzt, wird es zur Steuerungsebene (Control Plane) für den KI-Datenverkehr im Unternehmen: Es macht die Nutzung sichtbar und zuordenbar, während die Prüfung der Ausgaben und die Freigabe durch Menschen in der Anwendung bleiben.
Die meisten Teams, die KI in produktive Workflows ihres Unternehmens einbauen, konzentrieren sich auf das Modell: welcher Anbieter, welche Parameter, welches Prompt-Template. Das ist nachvollziehbar. Die schwierigere Frage stellt sich aber etwa drei Wochen nach dem Go-live: Wer ist für das Routing zuständig, wenn ein Modell um 02:00 Uhr in einen Timeout läuft? Wer kann der Revision sagen, wie viele Tokens ein einzelnes Team in einem bestimmten Quartal verbraucht hat? Und was genau passiert, wenn eine autonome Agentenschleife Anthropic rekursiv aufruft, weil niemand eine Obergrenze gesetzt hat?
Cloudflare AI Gateway sitzt als Proxy und Kontrollschicht zwischen Ihrer Anwendung und den dahinterliegenden KI-Anbietern (OpenAI, Anthropic, Workers AI, weitere sowie selbst betriebene Modelle als Custom Providers). Laut der Dokumentation von Cloudflare bündelt es Routing, Caching, Rate Limiting, Logging, Retries und Modell-Fallback in einer einzigen operativen Oberfläche (nach dem Muster seiner Referenzarchitektur „Multi-vendor AI observability and control“). Entscheidend an dieser Positionierung ist weniger, was sie hinzufügt, als was sie verhindert: unbeobachteten Inferenz-Datenverkehr, nicht zugeordnete Kosten und stille Ausfälle bei Anbietern, die als Kundenbeschwerden auffallen statt als Alarme.
Für Integrationsarchitekten, die in regulierten Umgebungen mit mehreren Anbietern arbeiten, ist das keine Komfortfunktion für Entwickler. Das Gateway wird zu der einen Stelle, an der KI-Aufrufe protokolliert, begrenzt und umgeleitet werden, und es verdient dieselbe architektonische Prüfung wie eine ESB-Migration oder die Einführung eines API-Gateways.
Das Logging von AI Gateway ist standardmäßig eingeschaltet und erfasst zu jeder Anfrage Prompt, Antwort, Anbieter, Status, Token-Verbrauch, Kosten und Dauer (die Speicherung der Payload lässt sich pro Anfrage abschalten, wenn Prompts personenbezogene Daten enthalten). Damit erhalten Engineering-Teams einen Audit Trail und ein menschlicher Prüfer zu jedem Aufruf den Prompt, die Antwort und die Kosten. Ohne dieses Logging ist KI in Unternehmens-Workflows (um eine Wendung zu borgen) teure Improvisation.
Interessanter ist die identitätsbezogene Auswertung. Steht das Gateway auf einer eigenen Domain hinter Cloudflare Access, ergänzt AI Gateway die Metadaten jeder Anfrage um die verifizierte Nutzer-ID (cf.user_id), sodass sich Logs, Analytics und Ausgaben nach authentifizierten Nutzern filtern lassen; Teams werden über benutzerdefinierte Metadaten gekennzeichnet. Aus einem allgemeinen Nutzungs-Dashboard wird so eine Ebene der Kostenverantwortung pro Nutzer und pro Team. Für Organisationen mit regulatorischen Transparenzpflichten ist diese Zuordnung nicht optional: Sie ist der Nachweis, wer welches Modell wie oft und zu welchen Kosten genutzt hat. (Die Kostenangaben sind Schätzungen aus Token-Zahlen und Modellpreisen; gleichen Sie sie daher mit der Rechnung des Anbieters ab.)
Eine Einschränkung sollte man klar aussprechen: AI Gateway ist keine vollständige Governance-Lösung. Seine Guardrails können schädliche Inhalte markieren oder blockieren, und Data Loss Prevention (DLP) kann sensible Daten erkennen, aber nichts im Gateway macht eine Antwort richtig oder erzwingt eine Freigabe durch Menschen. Die Referenzarchitektur „Enterprise AI agent workspace“ von Cloudflare rät, Modellausgaben als nicht vertrauenswürdig zu behandeln und Kontrollen an der Plattformgrenze anzusetzen. Die Validierung der Ausgaben und die Freigabe-Workflows gehören in die Anwendungsschicht. Das Gateway verschafft Ihnen Sichtbarkeit und eine erste Kontrolllinie. Was Sie daraus machen, bleibt eine Frage Ihrer Architektur.
Das Caching von AI Gateway (standardmäßig ausgeschaltet) liefert eine gespeicherte Antwort aus dem Cache von Cloudflare, statt den Anbieter aufzurufen, allerdings nur bei identischen Anfragen: Der Cache-Schlüssel umfasst den Endpunkt, das Modell, die Zugangsdaten des Anbieters und den vollständigen Request-Body (ein eigener Cache-Schlüssel kann Anfragen zusammenfassen, von denen Sie wissen, dass sie gleichwertig sind). Ein semantisches Caching ähnlicher Anfragen gibt es nicht; Cloudflare führt die semantische Suche für den Cache als geplant. Bei Workloads, die dieselbe Anfrage wiederholt senden, etwa statische Validierungsprüfungen mit festen Prompts, spart ein Cache-Treffer den Roundtrip zum Anbieter und den kostenpflichtigen Aufruf.
Ehrlich betrachtet hängt der Nutzen des Cachings allerdings vom Workload ab. Sind die Prompts sehr unterschiedlich oder müssen die Antworten jedes Mal neu erzeugt werden, bleiben die Cache-Trefferquoten niedrig und die Einsparungen gering. Cloudflare veröffentlicht keinen allgemeingültigen Benchmark für Einsparungen. Teams sollten ihre eigene Cache-Trefferquote messen (das Analytics-Dashboard zeigt den Anteil der Antworten aus dem Cache), ebenso die eingesparten Tokens und Kosten, statt von einem pauschalen Prozentsatz auszugehen.
Rate Limiting begrenzt das Anfragevolumen pro Gateway (mit festem oder gleitendem Zeitfenster), doch einzelne Anfragen können sich in der Größe von Prompt und Ausgabe enorm unterscheiden. Ein Rate Limit von 100 Anfragen pro Minute sagt nichts darüber, ob diese 100 Anfragen 2.000 Tokens verbraucht haben oder 200.000. Ausgabenlimits (Spend Limits) schließen einen Teil dieser Lücke: Sie verfolgen die geschätzten Kosten jeder Anfrage, lassen sich nach Modell, Anbieter, Nutzer oder Team aufteilen und blockieren weitere Anfragen, sobald ein Budget aufgebraucht ist. Sie sind allerdings nur eventually consistent (eine Lastspitze kann das Budget kurz überschreiten), und kein Budget begrenzt eine einzelne Anfrage. Das Gateway schützt Ihr Budget vor außer Kontrolle geratenen autonomen Schleifen (etwa vor fehlerhafter Agentenlogik, die über Nacht rekursive Abfragen ausführt), ersetzt aber keine Token-Limits pro Anfrage in Ihrem eigenen Code.
Cloudflare AI Gateway unterstützt Retries von Anfragen (bis zu fünf Versuche) und Modell-Fallback, konfiguriert in einer dynamischen Route: Die Anwendung nennt die Route statt eines Modells, und schlägt ein Modell nach seinen Retries fehl oder läuft es in einen Timeout, weicht die Route auf ein alternatives Modell aus. Routen sind versioniert, die Fallback-Kette lässt sich also ändern, ohne die aufrufende Anwendung anzupassen. Das ist die einheitliche Abstraktionsschicht über die Anbieter: ein einziger Endpunkt mit Failover über Modelle von Anthropic, OpenAI oder Workers AI.
In Brownfield-Umgebungen im Unternehmensumfeld (also dort, wo webMethods, SEEBURGER, IBM Sterling und Camunda in unterschiedlichen Modernisierungsständen bereits nebeneinander bestehen) ist diese Abstraktion architektonisch bedeutsam. Die Integrationsschicht braucht dann keine anbieterspezifische Retry-Logik, die über viele Services verstreut ist. Das Gateway wird zum Entscheidungspunkt für das Routing, und die Routing-Entscheidung wird auditierbar.
In Kombination mit Cloudflare Tunnel (cloudflared) kommt eine weitere Kontrolle hinzu: ausschließlich ausgehende Verbindungen von Ihrer Infrastruktur zum Netzwerk von Cloudflare. Keine offenen eingehenden Ports und keine öffentliche IP-Adresse für lokale Modellserver oder Integrationsendpunkte im Unternehmen; der Datenverkehr erreicht sie nur über Cloudflare, wo der DDoS-Schutz greift. Für Teams mit hybriden Architekturen, in denen On-Premises-Modellserver neben Cloud-Anbietern laufen, verbessert das die Sicherheitslage spürbar, ohne die Komplexität klassischer VPN- oder Firewall-Konfigurationen.
Gateways, Routen und Logs lassen sich nicht nur im Dashboard, sondern auch über die Cloudflare API verwalten, sodass die Einrichtung Teil Ihrer Deployment-Pipeline werden kann. Der Migrationspfad ist konkret: Richten Sie die KI-API-Aufrufe Ihrer Anwendung auf das Gateway (seinen anbieterspezifischen Endpunkt oder die OpenAI- und Anthropic-kompatible REST API), authentifizieren Sie sich, und das Gateway leitet als Proxy an den Anbieter weiter. Ab dann sind Logging, Caching, Rate Limits und Ausgabenlimits eine Frage der Konfiguration, nicht des Codes. Für Fallback braucht es einen Schritt im Code: den Aufruf einer dynamischen Route über ihren Namen, und eine solche Route akzeptiert nur das Request-Format von OpenAI Chat Completions.
Cloudflare positioniert das Gateway nicht nur für klassische Request-Response-Muster, sondern auch für autonome Agentenarchitekturen, in denen Kontrolle, Observability und Kostenobergrenzen existenziell statt optional sind: Ausgabenlimits können jedem Agenten ein eigenes Budget geben, und User Insights markiert Sitzungen, die auf einen aus dem Ruder laufenden Agenten hindeuten können. Dieses Signal sollten Sie genau lesen, wenn Ihre Teams agentische Workflows bauen.
Das Architekturmuster, das sich lohnt: ein cloudflared-Tunnel für den sicheren Zugang zu privaten Endpunkten, AI Gateway für zentrales Inferenz-Routing und zentrale Kontrollen, Cloudflare Access für die identitätsbezogene Zuordnung der Nutzung und Kontrollen in der Anwendungsschicht für die Validierung der Ausgaben und die Freigabe folgenreicher Aktionen durch Menschen. Keine einzelne Schicht erledigt alle vier Aufgaben; das Gateway zum Beispiel gibt nichts frei.
Wählen Sie einen KI-Aufruf, den ein Service bereits ausführt, mit einem Modell und einem Anbieter, und geben Sie ihm ein eigenes Gateway. KONDEVS kann helfen, wenn dieser Aufruf in einem Integrationsfluss (Enterprise Integration) oder in einem Agenten (Entwicklung von KI-Agenten) läuft.
- Legen Sie das Gateway in einem separaten Cloudflare-Konto an. Gateways werden im Dashboard oder über die API angelegt (Erste Schritte), und ein Token mit der Berechtigung AI Gateway Run gilt für jedes Gateway seines Kontos; ein separates Konto hält den Test daher getrennt. Schalten Sie das authentifizierte Gateway ein, richten Sie die Base URL des Aufrufs auf das Gateway und prüfen Sie, ob seine Anfragen in den Logs ankommen.
- Legen Sie fest, was die Logs aufbewahren. Standardmäßig speichern sie Prompts und Antworten. Enthält der Aufruf personenbezogene Daten, schalten Sie die Logs in den Einstellungen des Gateways ab oder senden Sie
cf-aig-collect-log-payload: false, damit nur die Metadaten erhalten bleiben, etwa Token-Zahlen, Modell, Status, Kosten und Dauer. - Kennzeichnen Sie jede Anfrage mit Team und Anwendung, und zwar im Header
cf-aig-metadata, damit sich die Logs nach Team filtern und ein Ausgabenlimit nach demselben Schlüssel aufteilen lassen. Steht das Gateway auf einer eigenen Domain hinter Cloudflare Access, kommtcf.user_idohne eigenen Code hinzu. - Setzen Sie ein Rate Limit und ein Ausgabenlimit so niedrig, dass Sie sie erreichen, und beobachten Sie, was die Anwendung mit dem 429 macht. Beide liefern
429 Too Many Requests. Entscheiden Sie, ob der Aufruf wartet und es später erneut versucht, die Arbeit in eine Queue stellt oder den Nutzer informiert; beim Ausgabenlimit kann eine dynamische Route stattdessen auf ein günstigeres Modell ausweichen. - Cachen Sie einen Aufruf, der identische Anfragen wiederholt, und lesen Sie nach zwei Wochen seine Trefferquote ab. Lassen Sie das Caching des Gateways ausgeschaltet und schalten Sie es nur für diesen Aufruf ein, mit einem
cf-aig-cache-key, den nur Anfragen mit gleichwertigen Antworten teilen, und einemcf-aig-cache-ttl, der so lang ist, wie die Antwort gültig bleibt.cf-aig-cache-statusmeldet bei jeder AntwortHIToderMISS; die Trefferquote entscheidet, ob der Aufruf seinen Cache behält.