Ein Käufer, der einen KI-Assistenten fragt: „Welche Beratungsunternehmen in Europa können die Integration unserer SAP-Landschaft übernehmen?“, bekommt eine ausformulierte Antwort, keine Seite voller Links. Der Assistent nennt einige Firmen, beschreibt jede in eigenen Worten und zitiert vielleicht ein oder zwei Quellen. Fehlt Ihr Unternehmen, erreicht der Käufer Ihre Website womöglich nie. Ist es dabei, aber falsch beschrieben, mit einem alten Namen oder einer Leistung, die Sie nicht mehr anbieten, liest der Käufer genau das zuerst.
Dieser Artikel beschreibt, wie ein Unternehmen in den Antworten von ChatGPT, Claude, Perplexity, Microsoft Copilot, Googles Übersichten mit KI (AI Overviews) und ähnlichen Werkzeugen auffindbar, lesbar und zitierfähig wird: was es selbst steuert, was nicht, und was wir auf kondevs.com umgesetzt haben. Unsere Fallstudie How we made kondevs.com usable by AI agents behandelt die andere Seite: Agenten, die auf der Website Tools aufrufen.
Die klassische Suche bringt Seiten in eine Rangfolge und zeigt Links, und der Nutzer liest Ihre Seite in Ihren Worten. Die Antwort eines großen Sprachmodells (LLM) ist dagegen selbst formuliert, und so kann sie Ihr Unternehmen nennen, ohne jemanden auf Ihre Website zu schicken. Sie zitiert Quellen oder eben nicht, und eine Erwähnung ohne Link hinterlässt in Ihrer Webanalyse keine Spur. Und sie beschreibt Sie in den Worten des Modells: Sind Ihre Seiten vage oder widersprechen sie sich, stammt die Beschreibung aus dem, was das Modell sonst noch über Sie hat.
Hinter jeder Antwort stehen drei Wege, und sie werden leicht verwechselt.
- Training. Ein Modell lernt aus Texten, die vor seinem Trainingsstichtag (Training Cutoff) gesammelt wurden; was es über Sie weiß, ändert sich erst mit einem neuen Modell. Crawler wie GPTBot von OpenAI und ClaudeBot von Anthropic sammeln Inhalte, die für das Training genutzt werden können.
- Suchindizes. Assistenten mit Websuche schlagen infrage kommende Seiten in einem Index nach. OpenAI erklärt, dass Websites, die den OAI-SearchBot sperren, in den Suchantworten von ChatGPT nicht angezeigt werden. Google erklärt, dass eine Seite indexiert und für die Anzeige mit einem Snippet geeignet sein muss, um in Übersichten mit KI oder im KI-Modus (AI Mode) als unterstützender Link zu erscheinen; weitere Anforderungen gibt es nicht.
- Abruf während der Antwort. Der Assistent ruft beim Antworten eine Seite ab und stützt seine Antwort darauf, eine Form der Retrieval-Augmented Generation. ChatGPT-User, Claude-User und Perplexity-User rufen Seiten auf diese Weise im Auftrag eines Nutzers ab.
Jeder Weg hat eigene Crawler, eigene Steuerungsmöglichkeiten und ein eigenes Tempo; keine einzelne Maßnahme deckt deshalb alle drei ab.
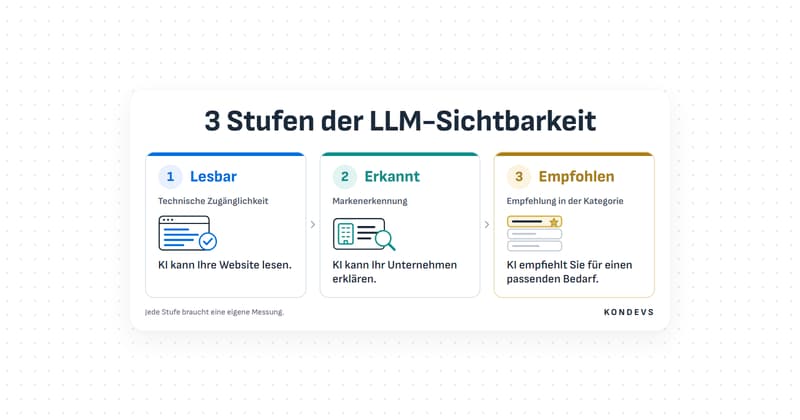
Diese Ebenen sind die Ursachen; die drei Stufen der LLM-Sichtbarkeit (lesbar, erkannt, empfohlen) sind das, was Sie testen. Zugang und eine lesbare Struktur entscheiden über Stufe 1, einheitliche Fakten dienen Stufe 2, und Vertrauen und Reichweite zählen am meisten für Stufe 3, bei der ein Assistent Sie für einen Bedarf empfiehlt, ohne dass ihm Ihr Name genannt wurde.
Zugang: Erreichen die Maschinen die Seite?
- Crawler-Regeln. Die robots.txt, als Robots Exclusion Protocol in RFC 9309 standardisiert, legt fest, welche Crawler welche Pfade abrufen dürfen. Sie ist eine Bitte, keine Zugriffskontrolle, und ein Crawler mit einer eigenen Gruppe ignoriert die Regeln, die für
*geschrieben sind. - Nutzungspräferenzen. Die Content Signals Policy von Cloudflare aus dem September 2025 ergänzt die robots.txt um drei Präferenzen:
search,ai-input(Nutzung in KI-Antworten zum Zeitpunkt der Anfrage) undai-train. Cloudflare nennt sie Präferenzen, keinen technischen Schutz. Wenn ein CDN Ihre robots.txt verwaltet, lesen Sie die Datei, die es tatsächlich ausliefert. - Text im HTML. Eine Seite, deren Text mit der ersten HTML-Antwort ankommt, kann jedes abrufende Programm lesen; eine Seite, die ihren Text erst im Browser aufbaut, ist darauf angewiesen, dass der Leser Skripte ausführt.
- Eine wahrheitsgetreue Sitemap und Änderungsmeldungen. Eine Sitemap mit jeder tatsächlich vorhandenen Seite und ehrlichen Datumsangaben, dazu IndexNow für Änderungen. Die IndexNow-Website nennt Amazon, Bing, Naver, Seznam.cz, Yandex und Yep (nicht Google), gibt eine Meldung an alle weiter und garantiert keine Indexierung.
Verständnis: Kann ein Modell die Seite richtig lesen?
- Inhalt ohne Layout-Rauschen. Menüs, Banner und wiederholte Fußzeilen verwässern den Text, den ein Modell erhält. Echte Überschriften, Listen und Tabellen helfen; eine schlichte Markdown-Fassung hilft noch mehr.
- Die Antwort zuerst. Erst die Antwort, dann die Details. Eine Definition, die mit „X ist ...“ beginnt, lässt sich für sich allein zitieren; Kernaussagen am Anfang und ein FAQ-Teil am Ende bringen die Kurzfassung an eine vorhersehbare Stelle. Ein Glossar legt Ihr Vokabular fest.
- Einheitliche Unternehmensfakten. Offizieller Firmenname, frühere Namen, Gründungsjahr, Anschrift, Register- und Umsatzsteuer-Identifikationsnummer, Leistungen und Personen, überall gleich. Ein Widerspruch wird zu einem Problem, das das Modell lösen muss, und es löst es womöglich falsch.
- Strukturierte Daten. JSON-LD nach schema.org hält die Fakten in maschinenlesbarer Form fest:
OrganizationmitlegalName,vatIDundsameAs,Person,Article,FAQPage,BreadcrumbList,DefinedTerm. Laut Google brauchen seine KI-Funktionen kein besonderes Schema, und strukturierte Daten sollten mit dem sichtbaren Text übereinstimmen; behandeln Sie Markup also als maschinenlesbare Kopie der Seite. Im Mai 2026 hat Google die Anzeige von FAQ-Rich-Results eingestellt; wir behaltenFAQPage, weil es jede Frage und jede Antwort für jeden Parser ausdrücklich benennt.
Vertrauen und Reichweite: Bestätigt jemand anderes, was Sie sagen?
- Quellen und namentlich genannte Autoren. Verlinkte Quellen zeigen, woher eine Aussage stammt; ein echter Autor mit Profil gibt ihr einen Verantwortlichen.
- Einheitliche Profile an anderer Stelle. Verzeichnisse, Partnerlisten der Hersteller, LinkedIn, Crunchbase und Wikidata, jeweils mit denselben Fakten wie Ihre Website und in Ihrem
Organization-Eintrag untersameAsverlinkt. - Erwähnungen durch andere. Artikel, Vorträge, Partnerseiten und Kundenreferenzen, die Sie nennen.
Diese Ebene liegt größtenteils außerhalb Ihrer Website, wirkt langsam und entzieht sich Ihrer Kontrolle. Am meisten zählt sie bei vergleichenden Fragen („Welche Firmen machen X in Y?“), denn um Sie mit anderen zu vergleichen, braucht ein Assistent andere Quellen als Ihre eigene Website.
Jeden der folgenden Punkte haben wir am 11. Oktober 2026 auf der Live-Website mit einfachen HTTP-Anfragen geprüft.
Zugang
- robots.txt enthält eine Gruppe für alle Crawler und eine, die zwölf KI-User-Agents nennt, darunter GPTBot, OAI-SearchBot, ClaudeBot, Claude-SearchBot, PerplexityBot und Google-Extended. Beide haben dieselben Regeln und geben
Content-Signal: search=yes, ai-input=yes, ai-train=yesan. Gesperrt ist nur die Publishing-API. Wir wollen indexiert, zitiert und zum Lernen genutzt werden; ein Unternehmen mit kostenpflichtigen Inhalten entscheidet vielleicht anders. Außerdem prüfen wir, dass die ausgelieferte Datei die ist, die wir geschrieben haben, und dass eine Anfrage mit dem User-Agent eines KI-Crawlers die Seite erhält und keine Challenge (Bot-Prüfung). - Serverseitiges Rendering. Jede Seite wird am Edge von Cloudflare gerendert, ihr Text steht also in der ersten HTML-Antwort. Mehr dazu: warum wir uns für Cloudflare Workers entschieden haben.
- Die Sitemap führt jede Seite und jeden Artikel auf (53 Adressen am 11. Oktober 2026), mit einem Änderungsdatum an jeder Adresse, und verknüpft jede Seite, die es in beiden Sprachen gibt, mit ihrem deutschen Gegenstück.
- IndexNow. Jeder Artikel, der über unsere Publishing-API veröffentlicht, geändert oder entfernt wird, meldet seine Adresse und die des Content Hub an IndexNow. Im Oktober 2026 haben wir zusätzlich die gesamte Sitemap übermittelt, und seit dem 19. Oktober 2026 ist die Website in der Google Search Console und den Bing Webmaster Tools verifiziert, die Sitemap bei beiden eingereicht.
- Volltext-Feeds. RSS und JSON Feed des englischen Content Hub enthalten die neuesten 50 Artikel vollständig; der deutsche Content Hub hat ein eigenes Paar.
Verständnis
- Markdown für jede Seite. Eine Anfrage mit
Accept: text/markdownliefert einen kurzen Kopfbereich (Titel, Beschreibung, kanonische Adresse, Sprache) und den Hauptinhalt, ohne Menüs, Fußzeilen oder Banner. Seit dem 17. Oktober 2026 gibt es dieselbe Antwort auch unter der.md-Adresse der Seite, etwa /about.md. - llms.txt folgt dem Format, das Jeremy Howard im September 2024 vorgeschlagen hat: eine kurze Zusammenfassung, „When to use KONDEVS“ (welche Seite welchen Bedarf beantwortet), „Key facts“ (Registerdaten, Gründungsjahr, Leistungen, Plattformen, namentlich genannte Projekte, Kontakt) und die wichtigsten Links. llms-full.txt fasst die Website in einer Datei zusammen (die neuesten Artikel vollständig, ältere als Link mit Zusammenfassung), erzeugt aus den Live-Inhalten und unter etwa 40.000 Token gehalten (rund 38.000 am 11. Oktober 2026).
- Ein JSON-LD-Graph pro Seite. Der Knoten
Organizationhat auf jeder Seite denselben Bezeichner und enthält den eingetragenen Namen, Register- und USt-IdNr., Anschrift, Gründungsjahr, frühere Namen, Gründer undsameAs. Autoren sindPerson-Knoten, die mit ihren Profilseiten verbunden sind. Artikel ergänzenArticle,BreadcrumbList,FAQPageund, wenn sie Quellen nennen,citation; Leistungsseiten ergänzenService; das Glossar ist einDefinedTermSet. Nichts wird ausgezeichnet, was die Seite nicht zeigt, und der eingetragene Name sowie Register- und USt-IdNr. stammen aus einem einzigen Datensatz im Code, der auch die Kontaktseite, die Fußzeile und die Datenschutzerklärung speist. - Kernaussagen, FAQs und ein Glossar. Jeder Artikel im Content Hub endet mit häufigen Fragen, und die englischen beginnen mit Kernaussagen; jede Leistungsseite endet mit häufigen Fragen. Das Glossar definiert 22 Begriffe, jeder beginnt mit „Was ist ...?“ und einer Antwort in einem Satz.
- Englisch und Deutsch. Die Unternehmensseiten, die Leistungen und das Glossar gibt es auf Deutsch unter /de/; jede Seite nennt ihr Gegenstück per
hreflang, und Markdown antwortet in der Sprache der Seite. Am 11. Oktober 2026 gab es die Artikel nur auf Englisch: Ein Artikel ohne deutsche Fassung hat keine deutsche Adresse, und sein Sprachumschalter führt zum deutschen Content Hub. Ein Assistent, der einen deutschsprachigen Käufer bedient, findet deutsche Seiten zum Unternehmen und zu seinen Leistungen, statt englische zu übersetzen.
Vertrauen und Reichweite
- Autoren und Quellen. Jeder Artikel nennt seinen Autor, mit einem Profil unter /de/authors/ und Links zu externen Profilen. Artikel, die sich auf Aussagen Dritter stützen, enden mit einer Quellenliste, aus der
citationwird. - Außerhalb der Website ist die Arbeit dieselbe wie für jedes Unternehmen: Verzeichnisprofile mit denselben Fakten wie auf der Website, verlinkt über
sameAs, und ein Wikidata-Eintrag, sobald unabhängige Quellen ihn stützen können.
Ein direkter Weg für Assistenten, die Tools aufrufen
Assistenten, die Tools aufrufen können, brauchen für unsere Inhalte keine Websuche: Der rein lesende MCP-Server unter POST /mcp bietet search_articles und get_article, das einen Artikel mit seinen Kernaussagen, häufigen Fragen und Quellen zurückgibt, und die llms.txt bittet die Assistenten, die Adresse des Artikels zu zitieren.
Sichtbarkeit in KI-Antworten lässt sich leicht schlecht messen: eine Frage, ein Durchlauf, ein Screenshot. Unsere Methode ist darauf angelegt, genau das zu vermeiden.
- Ein fester Satz von Fragen. Markenfragen (der Firmenname, die Domain; Stufe 2) und Käuferfragen, so formuliert, wie ein Käufer sie stellen würde, ohne unseren Namen (Stufe 3): nach Plattform, nach Region, nach Problem. Der Wortlaut ändert sich zwischen den Runden nie, damit eine andere Antwort eine veränderte Welt widerspiegelt und keine veränderte Frage.
- Feste Werkzeuge. Jede Frage läuft durch eine normale Websuche und eine KI-gestützte Suche, weil Assistenten, die im Web recherchieren, ihre Antworten aus Suchergebnissen aufbauen. Wir halten fest, ob kondevs.com erscheint, an welcher Stelle und ob Titel und Beschreibung auf dem neuesten Stand sind.
- Entitätsprüfungen. Wikidata, über seine API nach Name und nach offizieller Website abgefragt, und die Verzeichnisse, die Käufer zurate ziehen.
- Prüfungen der Indexierbarkeit. Der Robots-Header und das Robots-Meta-Tag auf Stichprobenseiten, die ausgelieferte robots.txt und der Umfang der Sitemap. Eine Messung sagt wenig aus, wenn sich die Website selbst gesperrt hat.
- Eine datierte Ausgangsmessung und ein Zeitplan. Die Ausgangsmessung (Baseline) fand am 29. September 2026 statt und wurde am 8. und 17. Oktober 2026 wiederholt. Jede Runde hält das Datum, die genaue Anfrage, das Ergebnis und die Links fest.
Dieser Artikel beschreibt die Methode, nicht unsere Ergebnisse. Was niemand genau messen kann:
- Antworten schwanken je nach Tag, Nutzer, Standort und Modellversion. Ein einzelner Durchlauf ist eine Anekdote.
- Es gibt keine vollständige Aufzeichnung. Kein Assistent veröffentlicht jede Antwort, die ein Unternehmen genannt hat, und eine Erwähnung ohne Link taucht in Ihrer Webanalyse nie auf.
- Die Berichte der Plattformen selbst sind lückenhaft. Der Leistungsbericht zu generativer KI in der Google Search Console, seit dem 31. August 2026 für alle Websites verfügbar, zählt nur Impressionen in Übersichten mit KI und im KI-Modus (nach Seite, Land, Gerät und Datum). Der Bericht „AI Performance“ in den Bing Webmaster Tools, im Februar 2026 als öffentliche Vorschau eingeführt, zählt Zitierungen in Copilot und in den KI-Zusammenfassungen von Bing, keine Besuche.
- Trainingsdaten sind eine Blackbox. Sie können nicht sehen, ob eine Seite in einem Trainingsdatensatz steckt oder wann ein Modell eine Änderung widerspiegeln wird.
- Ursachen lassen sich schwer belegen. Eine veränderte Antwort kann auf eine neue Modellversion oder die Seite eines Wettbewerbers zurückgehen statt auf Ihre Arbeit.
Wenn Sie einen Assistenten direkt fragen, nutzen Sie eine neue Sitzung ohne Verlauf, notieren Sie Modell und Datum, bewahren Sie die vollständige Antwort auf und fragen Sie mehr als einmal.
- Schreiben Sie Ihre Fakten einmal auf. Offizieller Firmenname, frühere Namen, Gründungsjahr, Anschrift, Register- und USt-IdNr., Leistungen, Personen und Kontakte, in einem zentralen Verzeichnis, aus dem jede Seite, jedes Profil und jedes Markup die Angaben übernimmt. Beseitigen Sie zuerst die Widersprüche.
- Legen Sie Ihre Crawler-Richtlinie fest und prüfen Sie dann, was ausgeliefert wird. Entscheiden Sie pro Crawler und Zweck: Suche, Antworten, Training. Lesen Sie die robots.txt, die Ihr CDN tatsächlich ausliefert.
- Machen Sie den Text ohne Browser lesbar. Rufen Sie Ihre wichtigsten Seiten mit einem einfachen HTTP-Client ab. Fehlen die Leistungsbeschreibungen, beheben Sie das Rendering, bevor Sie sich um Markup kümmern.
- Schreiben Sie die wichtigsten Seiten so um, dass die Antwort zuerst kommt. Jede Leistungsseite sollte in den ersten Zeilen sagen, worum es geht, für wen sie gedacht ist und was der Kunde bekommt, und mit den Fragen enden, die Käufer tatsächlich stellen.
- Ergänzen Sie strukturierte Daten, die zur Seite passen.
Organization,Person,Article,FAQPageundBreadcrumbListin einem Graphen mit stabilen Bezeichnern. Zeichnen Sie nie etwas aus, was die Seite nicht zeigt. - Veröffentlichen Sie eine kurze llms.txt und halten Sie den Index auf dem neuesten Stand. Die wichtigsten Fakten, wann man Sie heranziehen sollte, die wichtigsten Links; eine Sitemap mit korrekten Datumsangaben; IndexNow; die Website verifiziert in der Google Search Console und den Bing Webmaster Tools.
- Bauen Sie Ihre Präsenz außerhalb der Website auf, und messen Sie. Verzeichnisprofile mit denselben Fakten, Wikidata, sobald es unabhängige Belege gibt, alles verlinkt über
sameAs. Nehmen Sie die Ausgangsmessung vor, bevor Sie beginnen, damit Sie sehen, was sich bewegt hat.
Das meiste davon ist keine Marketingarbeit. Es ist ein einziger Satz von Fakten, konsistent über viele Schnittstellen veröffentlicht: Seiten, Markup, Dateien, Feeds und Tools. Dasselbe Problem lösen wir in Unternehmenslandschaften, in denen ein ERP, ein CRM und ein Partnerportal über denselben Kunden dieselbe Geschichte erzählen müssen. Wenn Sie klären wollen, was Ihre Website und Ihre Systeme KI-Assistenten zugänglich machen sollten, und in welcher Reihenfolge: Sprechen Sie mit einem Integrationsarchitekten. Nennen Sie uns Ihr Ziel, und wir sagen Ihnen ehrlich, wie wir es angehen würden.